 DROP #04 · R1 深度思考
窗内沉思:DeepSeek R1深度思考模型
在大规模强化学习驱动下自主展开长思维链,于静夜中为您抽丝剥茧解答复杂难题。
 雨夜窗景 · 侧抽屉导航
窗外霓虹微醺虚化,窗上薄雾指尖手写 DeepSeek —— 点击下方三颗雨滴唤醒右侧抽屉
透过雨夜玻璃的感性氛围,底层是 DeepSeek Harness 坚实的理性数据支撑:
DeepSeek-V3 在百科知识、高阶数学、代码工程与中文语境全面领跑开源模型并比肩国际顶尖闭源旗舰。
| 权威评测基准 (Benchmark) | DeepSeek-V3 (官方主模型) | DeepSeek-V2.5 | Qwen2.5-72B-Inst. | Llama-3.1-405B-Inst. | Claude-3.5-Sonnet | GPT-4o-0513 |
|---|---|---|---|---|---|---|
| 模型架构 / 激活参数规模 | MoE 671B (37B 激活) | MoE 236B (21B) | Dense 72B | Dense 405B | 商业闭源 | 商业闭源 |
| MMLU-Pro (综合学科推理 EM) | 75.9 | 66.2 | 71.6 | 73.3 | 78.0 | 72.6 |
| GPQA-Diamond (博士级科学问答) | 59.1 | 41.3 | 49.0 | 51.1 | 65.0 | 49.9 |
| MATH-500 (高阶数学竞赛 EM) | 90.2 | 74.7 | 83.6 | 73.8 | 78.3 | 74.6 |
| AIME 2024 (美国数学邀请赛 Pass@1) | 39.2 | 16.7 | 23.3 | 23.3 | 16.0 | 9.3 |
| LiveCodeBench (实时代码工程 Pass@1) | 40.5 | 29.2 | 31.1 | 28.4 | 38.9 | 33.4 |
| Codeforces (算法竞技百分位) | 51.6 | 35.6 | 24.8 | 25.3 | 20.3 | 23.6 |
| C-Eval (中文权威综合评测 EM) | 86.5 | 79.5 | 86.1 | 76.8 | 76.7 | 76.0 |
* 数据来源:DeepSeek Harness 标准评测集(DeepSeek - 探索未至之境)。第一列浅蓝高亮列代表本站点自研模型 DeepSeek-V3。
DROP #04 · R1 深度思考
在大规模强化学习驱动下自主展开长思维链,于静夜中为您抽丝剥茧解答复杂难题。
 DROP #05 · MLA 显存优化
将 128K 超长上下文 KV Cache 显存占用压缩 86.7%,让 DeepSeek V3满血版在线使用疾速流畅。
 DROP #06 · MoE 671B
如同城市夜色中精准亮起的窗口,每个词元仅激活最契合的 37B 专家参数。
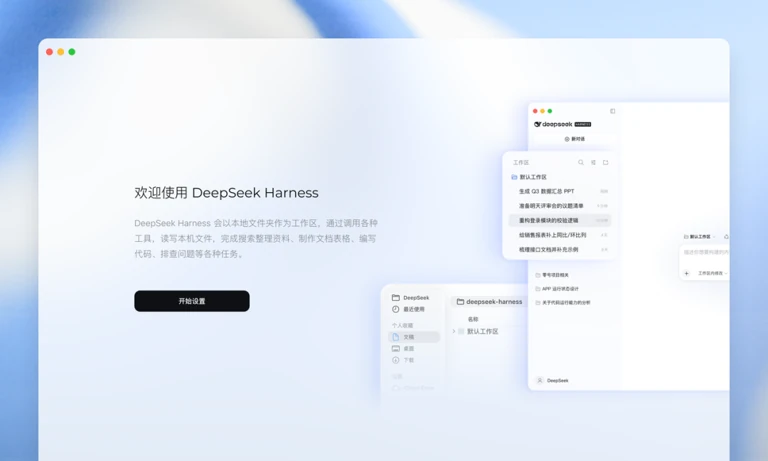 DROP #07 · API 硬盘缓存
DeepSeek api开放平台自动缓存高频重复前缀,命中后输入成本直降 90%。
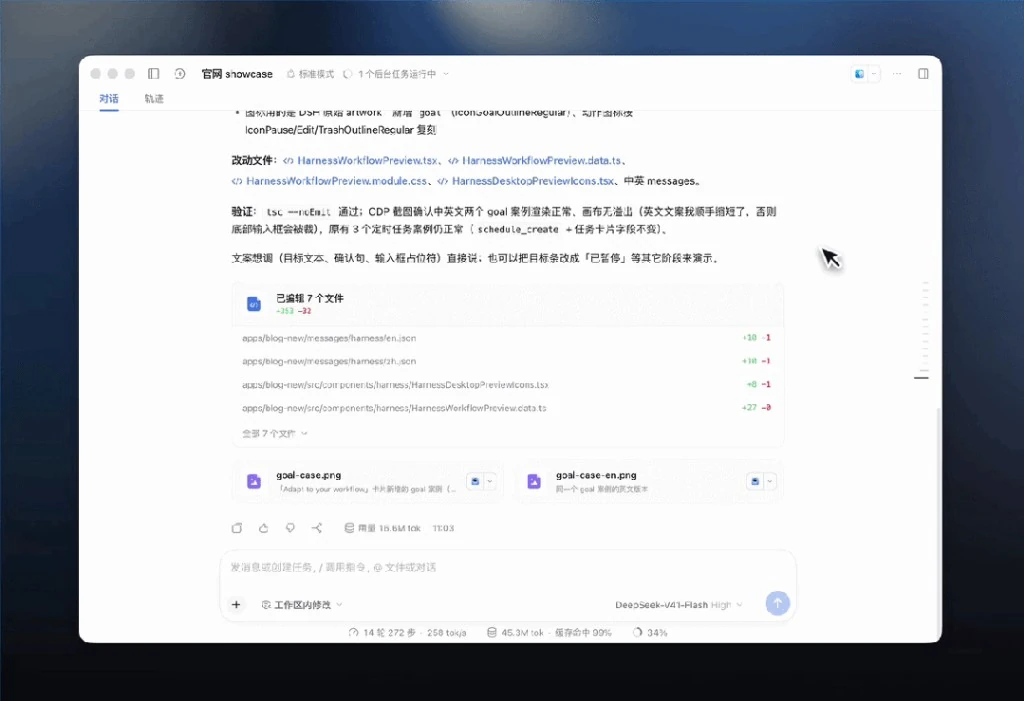 DROP #08 · Harness 校验
全链路透明可复现的基准测试体系,确保每一滴算力都纯粹可靠。
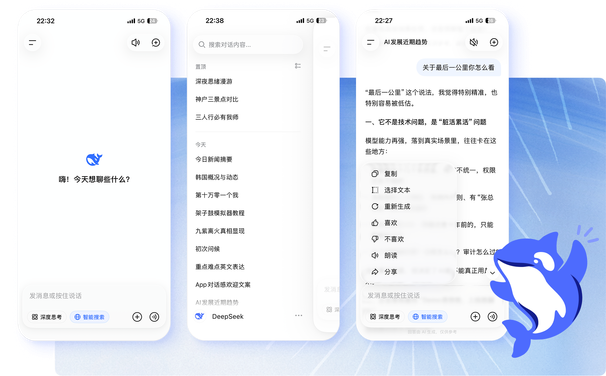 DROP #09 · 未至之境
坚持开源开放,与全球开发者和研究者并肩推开下一代通用人工智能之窗。